Документ превращается в проверяемую запись
AI pipeline для извлечения данных из документов
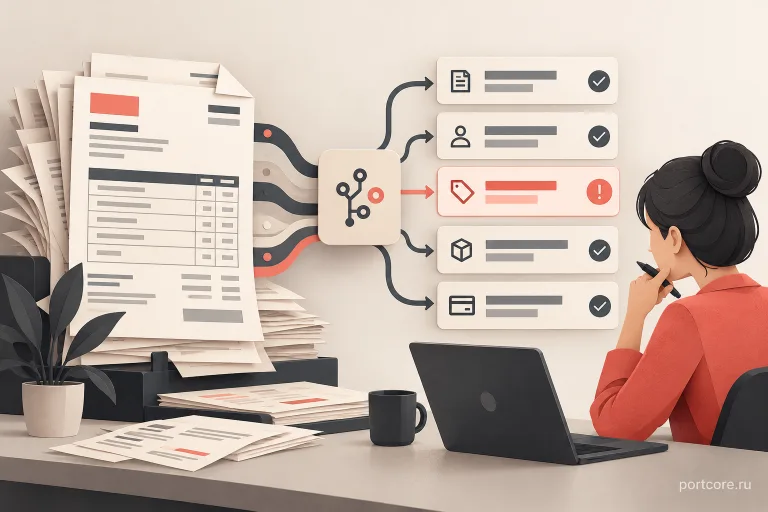
Строим pipeline извлечения данных из документов: исходник сохраняется, поля приводятся к структуре, сомнительные значения попадают на проверку. OCR подключается, если он нужен типу входа.
Сначала определить схему результата
Выбираем типы документов, нужные поля и допустимые форматы. Проверяем примеры разного качества и обозначаем ограничения входа. Разделяем распознавание изображения, извлечение смысла и проверку бизнес-правил. Это разные стадии: успешное чтение текста ещё не означает корректного заполнения всех реквизитов.
Один документ может содержать несколько похожих значений: даты, суммы, реквизиты и ссылки на приложения. До извлечения определяем смысл каждого выходного поля. Название колонки должно соответствовать бизнес-данным, а не первому похожему фрагменту, который удалось распознать.
Качество исходника влияет на состав обработки. Электронный текст, фотография и скан требуют разного входного контура. Отдельно рассматриваем несколько страниц, таблицы и недостающий фрагмент. Контрольный набор помогает определить, где нужен OCR, где извлечение по структуре и где обязательно участие человека.
Проверка перед передачей дальше
Настраиваем валидацию и ручную обработку неоднозначных полей. Связываем запись с исходным документом, журналом и статусом. Если требуется передача в CRM, учётную систему или staging, согласуем контракт и повторную обработку. Автоматическая публикация непроверенных значений не включается незаметно в общий импорт.
Валидация связывает извлечённое значение со схемой и доступными правилами. Сомнительное поле получает видимое состояние проверки. Сотруднику полезно видеть исходник и место, из которого взят результат, чтобы уточнение не превращалось в повторный ручной разбор документа целиком.
Выходная интеграция получает только согласованное состояние данных. Для передачи в CRM или другую систему определяем идентификатор, повторную обработку и журнал. Сохраняем различие между распознанным, проверенным и опубликованным результатом, чтобы ошибка раннего этапа не стала незаметной записью в учётном контуре.
Как оценивается качество извлечения
Сверяем поля с контрольным набором и разбираем типы ошибок отдельно. Должно быть понятно, какие данные приняты, какие требуют человека и где находится исходник.

Что включить в примеры документов
Понадобятся образцы разных форматов и качества, целевая схема полей и правила работы с пропусками. Полезны документы с неоднозначными значениями. Численную оценку качества строим на согласованной выборке, сохраняя виды ошибок и ограничения входа.
Разобрать документы для извлечения
Расскажите о текущем процессе, используемых системах и нужном результате. Для начала подойдёт краткое описание — уточняющие вопросы разберём вместе.
PORTcore · От задачи к решению
Документ должен превратиться в пригодные для работы данные
Извлечённое поле приносит пользу, когда правильно понято и дошло до нужной системы. Определим документ, целевые значения и место проверки человеком. На таком маршруте можно оценить, какую часть подготовки данных стоит автоматизировать, где остаются неоднозначности и как включить их разбор в ежедневную работу команды.