Создание ANTIFRAUD TRACKER для ограничения доступа ботов к офферу
Антифрод как расследование
Блокировка — последнее действие в длинной цепочке наблюдений.
Оффер получал посещения, но часть потока искажала воронку и создавала нагрузку. Моя задача состояла в том, чтобы связать подозрение с объяснимой причиной ограничения. В этом кейсе удобнее идти за одним визитом: от собранных событий к профилю риска, а затем — к решению, которое администратор может пересмотреть.
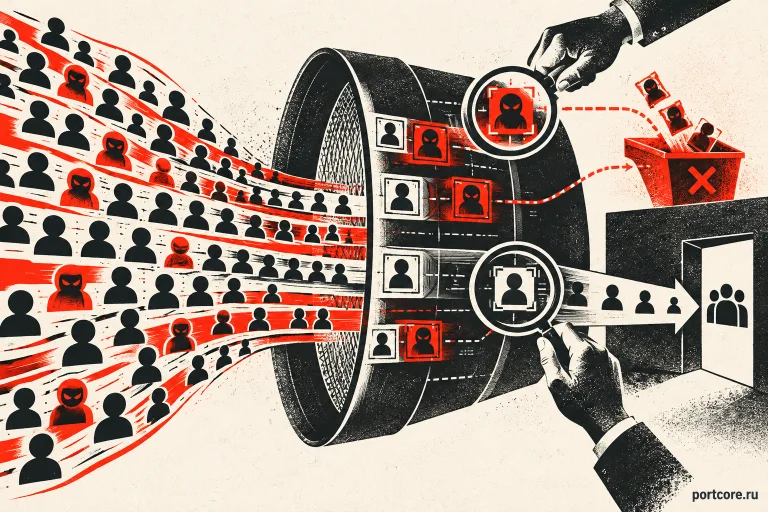
Досье визита: от наблюдения к решению
Я начал с точек входа и сигналов, которые можно собрать вокруг визита. Важна была связь между событием и последующим решением: администратор должен понимать, почему конкретный запрос оказался подозрительным. Поэтому фундаментом стал event tracking, а не непрозрачный список запрещённых посетителей. Событийная модель позволила перейти от отдельных наблюдений к профилю риска.
Технические и поведенческие признаки агрегировались, после чего rules engine сопоставлял их с порогами. У такой конструкции есть практический смысл: один странный признак не обязан означать автоматическое ограничение. В исходной задаче отдельно стоял риск массовых ложных блокировок, поэтому рядом с автоматикой появился контур ручной валидации и исключений.

Правило можно калибровать
Разработка двигалась через логирование, сегментацию, внедрение правил и отчётность. Такой порядок давал материал для калибровки: сначала увидеть паттерн, затем описать его условием и проверить решение на потоке. В административной части причины ограничений стали предметом анализа. Это отличает систему от набора фильтров, смысл которых остаётся только в голове разработчика.
PHP и MySQL использовались для серверного контура, хранения событий и административных сценариев. Rules engine отделял принятие решения от представления отчётов. Благодаря этому новые паттерны обхода можно было разбирать на языке сигналов и правил, а спорные случаи — возвращать на ручную проверку.

Когда я подключился к проекту "Создание ANTIFRAUD TRACKER для ограничения доступа ботов к офферу", картина была типичной для перегруженных систем: локальные решения уже существовали, но между бизнес-целью и техническим исполнением не было общей модели. Это приводило к повторяющимся инцидентам и росту ручной операционки.
Я отдельно разложил проблему на управляемые слои: входящие данные, правила обработки, точки принятия решений и контроль качества после релиза. Такой подход быстро показал, где именно теряется эффективность и почему прежние попытки стабилизации давали только краткосрочный эффект.
Вместо точечного "ремонта" я собрал последовательный сценарий внедрения: сначала зафиксировал критерии приемки, затем реализовал минимальное рабочее ядро и только после стабилизации перешел к расширению охвата. За счет этого команда получала измеримый прогресс на каждом этапе.
Особое внимание уделил эксплуатационному контуру: кто отвечает за качество, как фиксируются отклонения, где проходит граница между автоматикой и ручной валидацией. Именно этот слой сделал решение повторяемым и пригодным для масштабирования.
Архитектурно я опирался на принцип "сначала наблюдаемость, потом усложнение логики". Это позволило видеть влияние изменений в реальном времени и не терять управляемость при росте нагрузки.
Технологический стек (PHP, MySQL, event tracking, rules engine, admin workflows) использовался не как самоцель, а как средство контролируемой эволюции: каждое решение оценивалось по влиянию на скорость изменений, стабильность и стоимость сопровождения.
На уровне бизнеса это дало не только локальное улучшение метрик, но и понятную модель развития: стало ясно, какие действия действительно двигают проект, а какие создают шум. Команда начала принимать решения быстрее и с меньшим риском регрессий.
Я фиксировал результат в формате "до/после" и привязывал изменения к практическим KPI, чтобы у руководителя была прозрачная связь между инженерными шагами и коммерческим эффектом.
- Скорость реакции команды на отклонения и инциденты.
- Доля ручных операций до и после внедрения.
- Стабильность ключевого пользовательского сценария под нагрузкой.
- Предсказуемость релизов и число регрессий.
- Качество входящего потока: меньше шума, выше полезный результат.
- Архитектурная схема целевого контура с приоритетами внедрения.
- Пошаговый план rollout с критериями приемки по этапам.
- Регламент эксплуатации и эскалаций для команды.
- Набор практических чеклистов контроля качества после релиза.
- Список следующих итераций для роста эффекта в горизонте 30/60 дней.
Разобрать качество входящего трафика
Расскажите, где возникает подозрительный поток и как сейчас принимается решение об ограничении. Обсудим сигналы, правила и место ручной проверки.