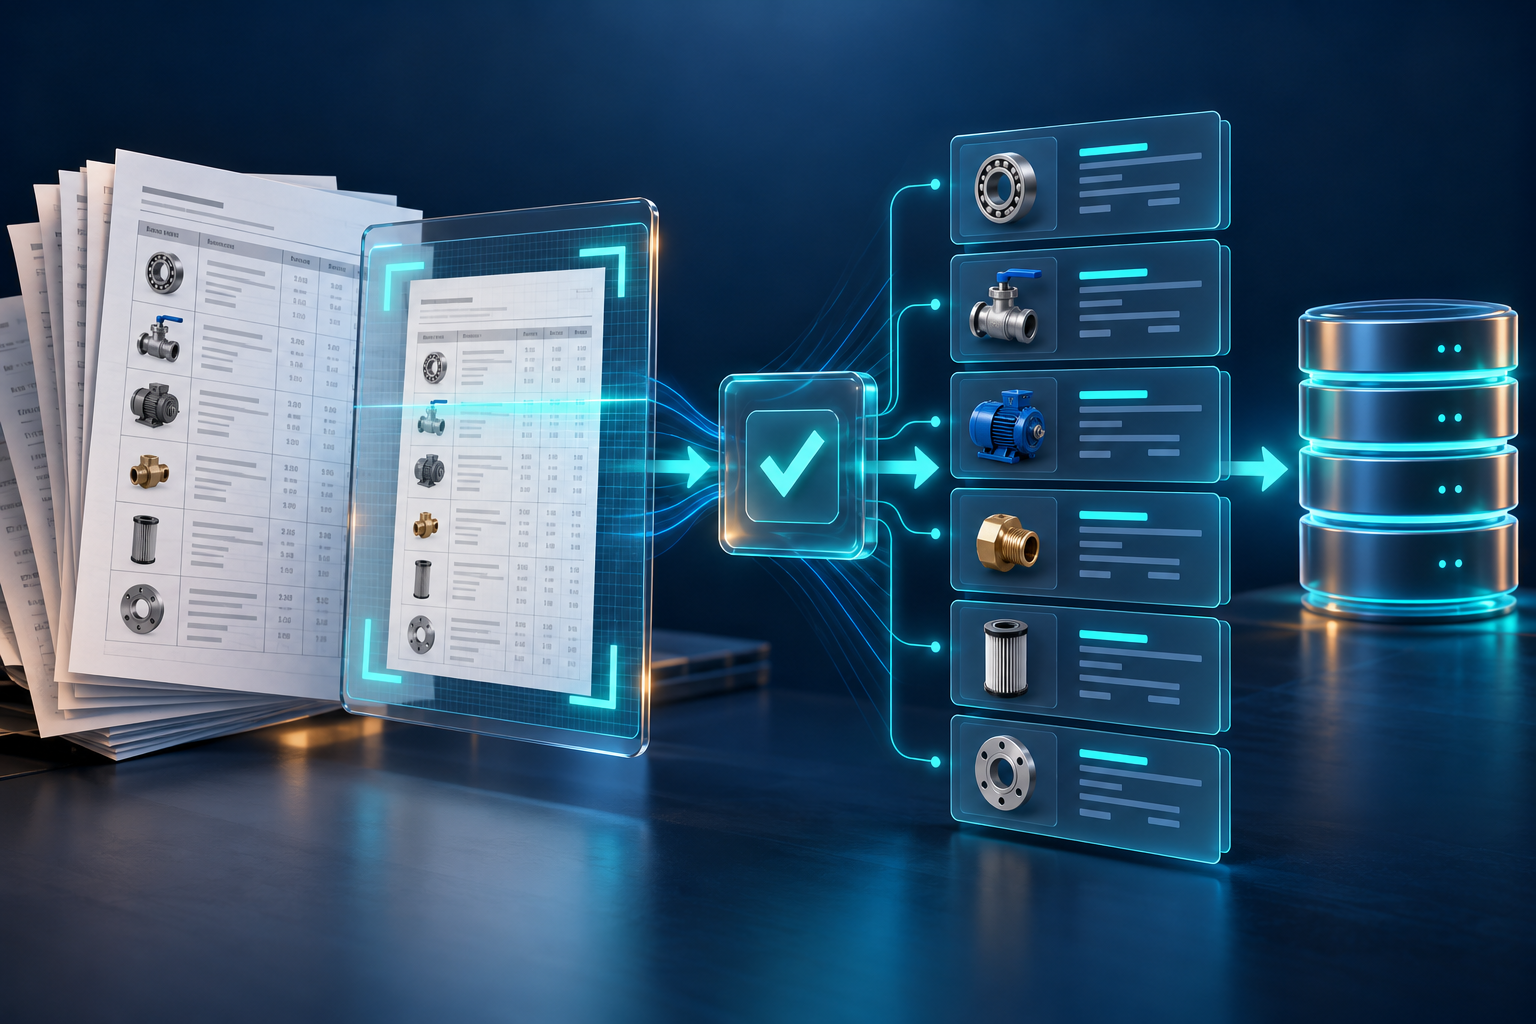
Типичная картина: поставщик присылает прайс в PDF раз в неделю или при каждом изменении цен. Внутри — таблица на несколько сотен строк с артикулами, наименованиями, характеристиками и ценами. Формат от прайса к прайсу слегка меняется: другой порядок колонок, объединённые ячейки, сноски внизу страницы, артикулы с пробелами или нестандартными разделителями.
Менеджер или контент-редактор открывает файл, вручную копирует строки в Excel, сопоставляет артикулы с позициями в каталоге, исправляет единицы измерения и передаёт результат для загрузки в 1С или Bitrix. Если позиций 300–500, цикл занимает несколько часов. Если поставщиков десять, процесс становится узким местом, которое тормозит обновление цен и остатков.
Проблема не в том, что PDF — плохой формат. Проблема в том, что у процесса нет структуры: нет зафиксированной карты полей, нет staging-слоя, нет критериев приёмки. Каждый прайс обрабатывается заново с нуля.
Что есть на входе и почему это важно зафиксировать
Прежде чем говорить об автоматизации, нужно ответить на вопрос: что именно содержит прайс и в каком виде. От ответа зависит сложность извлечения и объём ручной работы, которую невозможно убрать полностью.
Типичный состав PDF-прайса
| Поле в прайсе | Типичное представление | Сложность извлечения |
|---|---|---|
| Артикул поставщика | Текстовая ячейка, иногда с префиксом | Низкая, если нет OCR-артефактов |
| Наименование | Произвольная строка с сокращениями | Средняя: нужна нормализация |
| Характеристики | Встроены в наименование или в отдельные колонки | Высокая: требует разбора по паттернам |
| Единица измерения | Сокращения: шт, уп, кг, м.п. | Низкая после нормализации справочника |
| Цена | Число, иногда с разделителем тысяч | Низкая |
| Остаток / наличие | Число, «есть/нет», пустая ячейка | Средняя: нужна интерпретация |
| Изображение | Встроенное в PDF или отсутствует | Высокая: требует отдельной обработки |
Фиксация этой карты — первый артефакт, без которого нельзя начинать автоматизацию. Если у разных поставщиков разные форматы, карта составляется для каждого отдельно.
Что автоматизируем и что остаётся за человеком
Здесь важно избежать распространённого заблуждения: автоматизация PDF-прайса не означает, что человек выходит из процесса полностью. Речь идёт о том, чтобы убрать механическую работу и оставить человеку только содержательные решения.
Что поддаётся автоматизации
- Извлечение структурированных строк из PDF с табличным содержимым — через парсинг структуры документа или OCR, если PDF отсканирован.
- Нормализация значений: приведение единиц измерения к справочнику, очистка артикулов от лишних символов, стандартизация формата цены.
- Сопоставление артикула поставщика с внутренним артикулом каталога по заранее созданной таблице маппинга.
- Разбор характеристик из наименования по регулярным выражениям или языковой модели — если паттерны достаточно устойчивы.
- Запись результата в staging-таблицу с флагами уверенности по каждому полю.
Что остаётся за человеком
- Приёмка новых позиций, которых нет в таблице маппинга: решение о создании новой карточки или отклонении.
- Проверка позиций с низкой уверенностью извлечения — например, когда характеристика не распознана однозначно.
- Контроль аномалий цены: резкий рост или падение относительно предыдущего прайса.
- Финальное подтверждение публикации в каталог и передачи в 1С.
Граница между машинной и ручной работой — это не технический вопрос, а операционное решение. Его нужно принять до начала разработки, зафиксировать в критериях приёмки пилота и пересматривать по мере накопления данных о качестве извлечения.
Схема обмена: от PDF до публикации
Ниже — демонстрационная схема процесса. Это иллюстрация архитектурного подхода, а не описание конкретного выполненного проекта.
PDF-прайс поставщика
        │
        ▼
[Извлечение] — парсер структуры PDF или OCR-слой
        │
        ▼
[Нормализация] — очистка артикулов, единиц, цен
        │
        ▼
[Маппинг] — сопоставление с внутренним справочником
        │         └─ новые позиции → очередь на ручную приёмку
        ▼
[Staging-таблица] — строки с флагами уверенности
        │
        ▼
[Ручная приёмка] — проверка флагов, аномалий, новых позиций
        │
        ▼
[Публикация] — обновление каталога + передача в 1С
Ключевой элемент схемы — staging-слой. Он отделяет «сырые» данные от опубликованных. Пока строка находится в staging, она не попадает в каталог и не уходит в 1С. Это защищает от публикации некорректных данных и даёт оператору время на проверку.
Таблица маппинга: почему без неё ничего не работает
Маппинг — это соответствие между артикулом поставщика и внутренним идентификатором позиции в вашем каталоге. Без этой таблицы каждый новый прайс будет создавать дубли или требовать ручного сопоставления с нуля.
Минимальный состав таблицы маппинга:
- Артикул поставщика (как он приходит в прайсе, включая варианты написания).
- Внутренний артикул каталога.
- ID поставщика — чтобы один артикул у разных поставщиков не конфликтовал.
- Статус: активен, устарел, требует проверки.
- Дата последнего обновления.
Таблица маппинга — живой документ. Первая версия заполняется вручную или полуавтоматически при первом прогоне. Дальше она пополняется по мере появления новых позиций. Именно поэтому процесс ручной приёмки новых позиций нельзя убрать: каждая новая позиция — это решение о добавлении строки в маппинг.
Демонстрационный сценарий: входные данные → staging → приёмка
Рассмотрим условный пример, чтобы показать, как работает цикл на практике.
Входные данные (условные): прайс на 420 позиций, PDF с машиночитаемым текстом, таблица на 5 колонок: артикул, наименование, ед. изм., цена, наличие. Поставщик — один, маппинг для 380 позиций уже существует.
После извлечения и нормализации:
- 380 строк сопоставлены автоматически, флаг уверенности «высокий».
- 28 строк — артикул найден в маппинге, но цена изменилась более чем на 20% относительно предыдущего прайса → флаг «аномалия цены», требует подтверждения.
- 12 строк — новые позиции, отсутствующие в маппинге → очередь на ручную приёмку.
Работа оператора: просматривает 40 строк (28 + 12), а не 420. По каждой из 28 строк с аномалией принимает решение: подтвердить новую цену или отложить до уточнения у поставщика. По 12 новым позициям: создать карточку, пропустить или добавить в маппинг как псевдоним существующей позиции.
Результат: оператор работает с 9% строк вместо 100%. Остальные 91% обновляются автоматически после финального подтверждения публикации.
Это демонстрационный расчёт на условных данных. Реальное соотношение зависит от качества PDF, стабильности формата и полноты существующего маппинга.
Критерии приёмки пилота
Прежде чем масштабировать процесс на всех поставщиков, пилот нужно принять по измеримым критериям. Вот минимальный чеклист:
- Точность извлечения артикула: доля строк, где артикул извлечён без ошибок — целевой порог согласуется до начала пилота.
- Точность сопоставления: доля строк, где маппинг сработал корректно без ручного вмешательства.
- Доля строк, ушедших на ручную приёмку: должна снижаться от прайса к прайсу по мере накопления маппинга.
- Отсутствие публикаций с некорректными данными: ни одна строка не должна попасть в каталог или 1С, минуя staging и подтверждение оператора.
- Время цикла обработки одного прайса: от получения файла до готовности staging-таблицы к приёмке.
Эти критерии фиксируются письменно до начала разработки. Они же используются для решения о масштабировании на следующего поставщика.
Границы продукта и отдельной разработки
Модуль portcore.exchange строит конвейер обработки каталожных данных: принимает RAW-импорт, нормализует значения, применяет маппинг и публикует результат в Bitrix через staging-слой. Управление ценами, остатками и агрегатами — внутри продукта.
Важная граница: извлечение данных из PDF, OCR-обработка отсканированных документов и разбор характеристик из произвольных наименований с помощью языковой модели — это отдельная интеграция, которая разрабатывается под конкретный формат прайса. Она не входит в базовую поставку модуля. Это означает, что перед запуском нужно согласовать карту полей, оценить качество PDF и определить, какой метод извлечения подходит для вашего случая.
Если каталог уже накопил дубли и лишние свойства после нескольких ручных загрузок, полезно параллельно посмотреть на portcore.catalogstructure — он показывает дерево разделов, анализирует заполненность свойств и помогает найти проблемные ветки до того, как в них попадут новые данные из прайса.
Для команд, которые хотят дополнительно автоматизировать модерацию входящих карточек — проверку заполненности обязательных полей, флаги подозрительных значений, маршрутизацию на ответственного, — это реализуется через AI-модерацию каталога и заявок как отдельный сервис поверх staging-слоя.
Что нужно подготовить для разбора
Чтобы оценить объём работы и предложить конкретную архитектуру, нам нужно посмотреть на реальный материал. Для первого разбора достаточно:
- Обезличенный пример прайса в PDF — 1–2 страницы, достаточные для понимания структуры.
- Список полей, которые нужно извлечь, и их соответствие полям каталога или 1С.
- Информация о том, машиночитаемый PDF или отсканированный.
- Примерное количество поставщиков и частота обновления прайсов.
На основе этих данных можно оценить сложность извлечения, предложить метод и согласовать критерии пилота. Без примера прайса любая оценка будет приблизительной.
Если вы сейчас выбираете между ручной обработкой, универсальным конвертером и заказной разработкой — посмотрите разбор критериев выбора в статье «Готовый продукт или заказной ИИ-сервис: критерии выбора для компании». А если задача шире и касается подготовки всего каталога к пилоту с ИИ — там есть пересечение с разбором в статье «MVP ИИ-продукта: проверка спроса, границы функций и пилот».
Следующий шаг
Если процесс обработки PDF-прайсов занимает значительное время вашей команды и вы хотите разобрать, как его структурировать, — пришлите обезличенный пример прайса и опишите, какие поля нужны на выходе. Мы разберём структуру, предложим карту полей и согласуем критерии пилота.
Требования к данным и интеграциям перед запуском
Прежде чем запускать конвейер обработки, важно зафиксировать требования к данным — не в момент пилота, а до его начала. Это снижает количество итераций и позволяет корректно оценить объём разработки.
Требования к входным данным
- Тип PDF: машиночитаемый (текстовый слой присутствует) или отсканированный (требуется OCR). Это принципиально разные методы извлечения с разным порогом точности.
- Стабильность структуры: меняется ли расположение колонок от версии к версии прайса. Если поставщик периодически меняет шаблон — это должно быть учтено в логике парсера.
- Кодировка и язык: кириллические наименования в PDF могут давать артефакты при извлечении — особенно при использовании нестандартных шрифтов.
- Вложенные таблицы и объединённые ячейки: если прайс содержит группировку по категориям с объединёнными строками, это усложняет парсинг и требует отдельной логики разворачивания.
- Многостраничность и разрывы таблиц: таблица, разбитая на несколько страниц с повторяющимися заголовками, требует логики склейки строк.
Требования к интеграции с 1С
- Формат выгрузки из staging в 1С должен быть согласован заранее: CommerceML, CSV с фиксированной структурой или прямой API-вызов.
- Поля, обязательные для 1С (например, единица измерения в формате классификатора, НДС, код склада), должны быть либо присутствовать в прайсе, либо подставляться из справочника по умолчанию.
- Если в 1С уже есть номенклатурная карточка, обновление должно идти по внутреннему коду, а не по наименованию — иначе возникают дубли.
- Частота синхронизации: разовая выгрузка после каждого прайса или периодическая фоновая — влияет на архитектуру очереди.
Роль человека в автоматизированном процессе
Автоматизация не убирает человека из процесса — она меняет его роль. Вместо рутинного переноса данных оператор принимает решения там, где машина не уверена. Это важно зафиксировать как организационное требование, а не только техническое.
Где человек остаётся необходимым
- Приёмка новых позиций: каждая строка без маппинга требует решения — создать новую карточку, привязать к существующей или отклонить. Это бизнес-решение, которое нельзя делегировать алгоритму без явных правил.
- Подтверждение аномалий цены: если цена выросла на 40% — это ошибка в прайсе или реальное изменение? Только оператор, знающий контекст поставщика, может это оценить.
- Финальное подтверждение публикации: даже если 95% строк прошли автоматически, публикация в каталог и передача в 1С должны требовать явного действия ответственного. Это контрольная точка, а не формальность.
- Обновление правил нормализации: когда поставщик меняет формат единиц измерения или способ написания артикула — кто-то должен обновить справочник синонимов. Это регулярная эксплуатационная задача.
Антипаттерн: «запустили и забыли»
Частая ошибка при внедрении — ожидание, что после настройки конвейер будет работать без сопровождения. На практике: поставщики меняют шаблоны, появляются новые позиции, накапливаются исключения. Без назначенного ответственного за эксплуатацию маппинг устаревает, а качество автоматического сопоставления деградирует. Это не недостаток архитектуры — это свойство любой живой интеграции с внешними источниками данных.
Ограничения и эксплуатационные затраты
Честная оценка внедрения включает не только эффект от автоматизации, но и постоянные затраты на поддержание системы в рабочем состоянии.
Технические ограничения
- Качество PDF напрямую влияет на точность извлечения. Отсканированные документы с низким разрешением, наклоном страницы или нечёткими символами дают более высокий процент ошибок — это не устраняется настройкой, а компенсируется увеличением доли ручной приёмки.
- Нестабильный формат прайса — если поставщик меняет структуру таблицы раз в квартал, парсер потребует обновления при каждом изменении. Это плановая задача, а не аварийная ситуация, но её нужно учитывать в трудозатратах.
- Языковые модели для разбора характеристик дают вероятностный результат. Флаг уверенности снижает риск, но не устраняет его: строки с низким confidence всегда уходят на ручную проверку.
Эксплуатационные затраты
- Поддержка таблицы маппинга: регулярное добавление новых позиций, актуализация статусов устаревших артикулов, разрешение конфликтов при смене артикула поставщиком.
- Обновление справочников нормализации: синонимы единиц измерения, варианты написания брендов, форматы артикулов — живые документы, требующие сопровождения.
- Мониторинг качества: периодический контроль доли ошибок извлечения и точности маппинга. Деградация метрик — сигнал к обновлению правил или парсера.
- Обработка исключений: прайсы с нестандартной структурой, повреждённые файлы, прайсы на нескольких языках — требуют ручного вмешательства вне штатного процесса.
Понимание этих затрат до запуска позволяет корректно оценить окупаемость автоматизации и не разочаровываться в системе при первых нештатных ситуациях.
Связанные материалы
Подходящие офферы
Если статья попала в вашу задачу, вот два оффера, с которых можно перейти к внедрению без лишнего discovery.