Типичная картина на аудите: каталог накапливался годами, у части позиций нет описаний, у другой части описания скопированы из прайса поставщика дословно, атрибуты заполнены непоследовательно, а обмен с учётной системой работает по схеме «выгрузить всё и перезаписать». Когда в такой контур пытаются встроить ИИ-генерацию описаний или умный поиск, результат предсказуем: модель воспроизводит мусор с уверенным тоном.
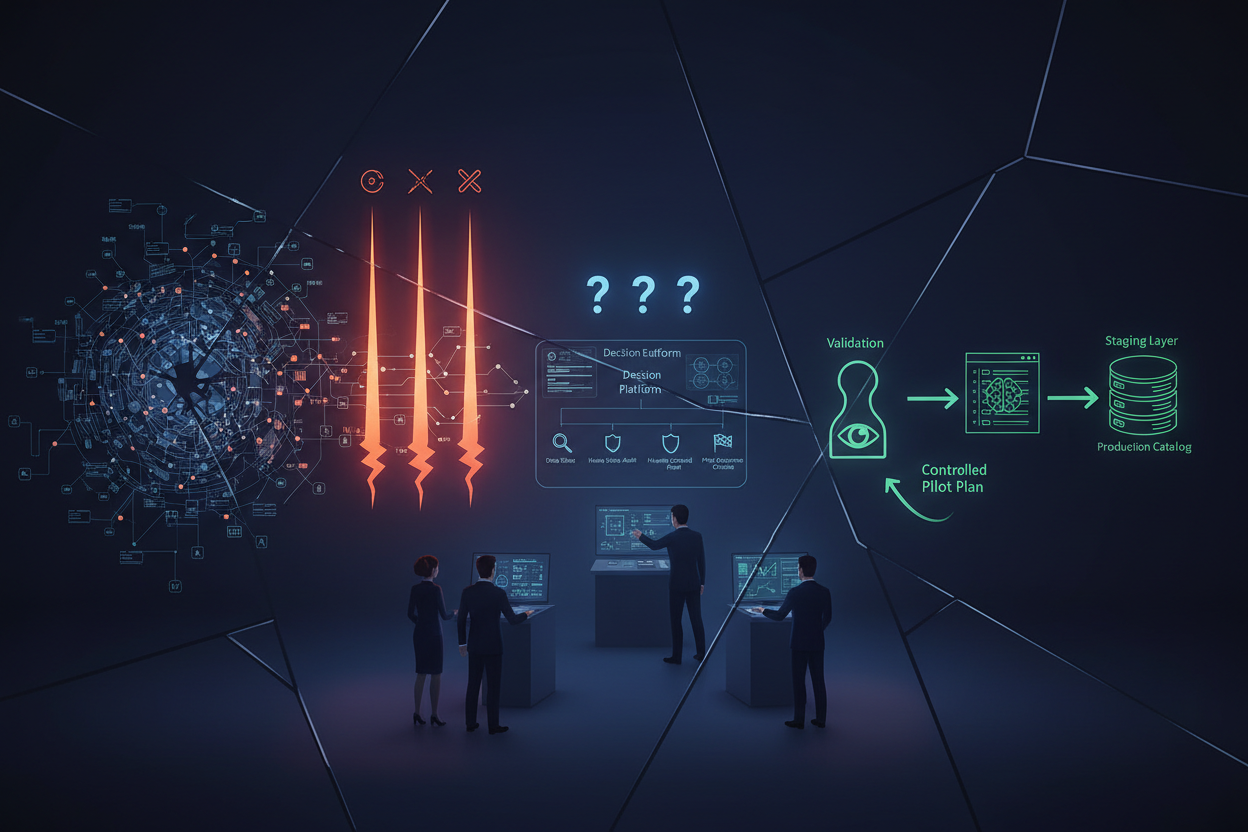
Проблема не в ИИ. Проблема в том, что данные не прошли нормализацию, а конвейер обменов не имеет staging-слоя, где можно остановить результат до публикации и проверить его человеком. Именно эта точка — staging с подтверждением — делает ИИ-пилот управляемым.
Два подхода к реализации: готовый модуль или заказная разработка
Прежде чем выбирать архитектуру пилота, стоит честно ответить: есть ли у вас платформа, к которой уже можно прикрутить готовый инструмент, или нужна интеграция с нуля?
Подход 1: надстройка над существующим конвейером обменов
Если каталог живёт на 1С-Битрикс и обмен с 1С уже настроен, первый шаг — не ИИ, а аудит самого конвейера. Типичные разрывы, которые мы видим при разборе:
- RAW-импорт из 1С публикуется напрямую без нормализации значений атрибутов;
- маппинг характеристик отсутствует или хранится в коде, а не в конфигурации;
- дубли разделов и лишние свойства накоплены за несколько лет роста каталога;
- нет staging-слоя: любое изменение сразу уходит в продакшн.
Без устранения этих разрывов ИИ-слой будет работать с грязными данными и генерировать контент, который всё равно придётся проверять вручную — только теперь в большем объёме.
Для диагностики такого конвейера подходит инструментальный подход: модуль portcore.catalogstructure показывает дерево разделов, анализирует заполненность свойств по веткам и находит дубли. Модуль portcore.exchange строит конвейер с RAW-приёмом, нормализацией, маппингом и staging-слоем перед публикацией — это именно та точка, в которую потом встраивается ИИ-шаг с подтверждением.
Подход 2: заказная интеграция ИИ-микросервиса
Если платформа не Битрикс или нужна более сложная логика — классификация по нескольким источникам, обогащение из внешних справочников, генерация описаний с отраслевым контекстом — задача решается через отдельный ИИ-микросервис, который встраивается в существующий конвейер через API. Здесь важно зафиксировать контракт заранее: что подаётся на вход, что ожидается на выходе, какой формат флага «требует проверки человеком».
| Критерий | Надстройка над конвейером | Заказной ИИ-микросервис |
|---|---|---|
| Скорость старта пилота | Быстрее: платформа уже есть | Дольше: нужна архитектура контракта |
| Гибкость логики | Ограничена платформой | Полная, под задачу |
| Зависимость от платформы | Высокая | Низкая |
| Стоимость пилота | Ниже при наличии платформы | Выше, но переиспользуется |
| Staging с подтверждением | Встроен в модуль обмена | Проектируется отдельно |
Архитектура ИИ-слоя: где живёт человек-контролёр
Ключевой принцип управляемого пилота — ИИ не публикует самостоятельно. Любой результат, который выходит за пороговое значение уверенности модели, уходит в очередь на проверку. Это не ограничение, а архитектурное решение, которое позволяет накапливать данные о качестве и постепенно расширять автономию модели.
Схема конвейера в демонстрационном сценарии выглядит так:
RAW-данные из 1С / прайса
        ↓
  Нормализация и маппинг
        ↓
  ИИ-шаг: генерация / классификация / обогащение
        ↓
  Scoring: уверенность модели
   ├─ выше порога → staging → авто-публикация
   └─ ниже порога → очередь на проверку человеком
        ↓
  Подтверждение / правка / отклонение
        ↓
  Публикация в каталог
Scoring-порог на старте пилота выставляется консервативно: лучше направить 60% карточек на проверку и убедиться в качестве, чем опубликовать 90% с ошибками. По мере накопления подтверждённых примеров порог можно поднимать — это и есть управляемое расширение автономии.
Что нужно зафиксировать до старта пилота
- Объём выборки: минимальная репрезентативная выборка для пилота — обычно 200–500 карточек из разных категорий, а не только «простые» позиции;
- Исходные данные: список обязательных атрибутов, которые должны быть заполнены до подачи на ИИ-шаг;
- Критерии качества: что считается приемлемым результатом — формальные признаки (длина описания, наличие ключевых атрибутов) и экспертная оценка выборки;
- SLA проверки: за сколько часов контролёр должен обработать очередь;
- Критерии масштабирования: при каком проценте авто-публикации без правок пилот считается успешным.
Контроль рисков: три точки, где пилот ломается
1. Мусор на входе
ИИ-модель не исправляет структурные проблемы данных — она их усиливает. Если атрибут «единица измерения» заполнен в 30% карточек и в трёх разных форматах, модель будет галлюцинировать значения для остальных 70%. Решение: нормализация и валидация данных до ИИ-шага, а не после.
2. Отсутствие staging-слоя
Самый частый технический долг: ИИ-результат сразу уходит в продакшн через тот же механизм, что и обычный импорт. Это лишает возможности контролировать качество и откатить изменения. Staging — не опция, а обязательное условие управляемого пилота.
3. Размытые критерии приёмки
«Описания стали лучше» — не критерий. Критерий: «85% описаний прошли проверку без правок по формальным признакам, 10% потребовали минорной правки, 5% отклонены». Без такой разбивки невозможно принять решение о масштабировании.
Исходные данные: что нужно подготовить до пилота
Перед запуском ИИ-пилота команда должна собрать следующий пакет данных:
- Выгрузка каталога с заполненностью атрибутов по разделам — показывает, где данные готовы к ИИ-шагу, а где нужна предварительная работа;
- Схема текущего обмена с учётной системой: частота, формат, наличие staging;
- Список атрибутов, которые должны генерироваться или обогащаться ИИ;
- Примеры «эталонных» карточек — 20–30 штук, по которым будет калиброваться модель;
- Контакт контролёра: кто будет принимать очередь на проверку в рамках пилота.
Этот пакет позволяет оценить объём подготовительной работы и сформировать реалистичный бюджет пилота. Статья MVP ИИ-продукта: проверка спроса, границы функций и пилот на реальных данных подробнее разбирает, как ограничить периметр первой версии и не уйти в бесконечный скоуп.
Пошаговый план пилота
Шаг 1. Аудит данных и конвейера (1–2 недели)
Анализ заполненности атрибутов, схемы обмена, наличия staging. Результат: карта разрывов и список задач нормализации.
Шаг 2. Нормализация и маппинг (1–3 недели)
Приведение атрибутов к единому формату, настройка маппинга, создание staging-слоя. Это фундамент — без него ИИ-шаг не имеет смысла.
Шаг 3. Настройка ИИ-шага и scoring (1–2 недели)
Интеграция модели в конвейер, настройка порога уверенности, подключение очереди на проверку. Демонстрационный сценарий: генерация описания карточки по набору атрибутов с флагом «требует проверки» при уверенности ниже 0.75.
Шаг 4. Пилотный прогон на выборке
Прогон на 200–500 карточках, ручная проверка очереди, замер метрик: доля авто-публикации, доля правок, доля отклонений.
Шаг 5. Разбор результатов и решение о масштабировании
Сравнение с критериями приёмки. Если метрики достигнуты — расширение выборки и постепенный подъём порога. Если нет — анализ причин: данные, промпт, маппинг.
Экономика пилота: условный расчёт
Оценить эффект пилота можно через простую формулу до его запуска:
Экономия на ручном контенте =
  (Кол-во карточек × Время на одну карточку вручную × Ставка редактора)
  × Доля авто-публикации без правок
Пример (демонстрационный, не гарантированный): если каталог содержит 5 000 карточек, ручное описание одной занимает 20 минут, а ставка редактора — X рублей в час, то при 70% авто-публикации пилот освобождает значительный ресурс. Реальные цифры зависят от качества исходных данных и сложности категорий — именно поэтому пилот начинается с выборки, а не сразу с полного каталога.
О том, как выбирать между готовым продуктом и заказной разработкой для ИИ-задачи, подробно написано в статье Готовый продукт или заказной ИИ-сервис: критерии выбора для компании.
Что выбрать: автогенерация контента или ИИ-модерация каталога
Два наиболее частых сценария для каталогов — генерация описаний и модерация входящих карточек — решаются разными инструментами.
Если задача — массово создать описания для позиций, у которых их нет, подходит автогенератор контента: система работает по шаблонам с атрибутами, генерирует черновики и направляет их в очередь проверки.
Если задача — контролировать качество карточек, поступающих из нескольких источников (поставщики, менеджеры, импорт), нужна AI-модерация каталога: классификация, флаги риска и маршрутизация на нужного контролёра.
В большинстве проектов эти два сценария запускаются последовательно: сначала модерация и нормализация существующего каталога, затем генерация для новых позиций.
Обсудите пилот с командой PORTcore
Если вы готовите каталог к внедрению ИИ или хотите разобраться, с чего начать, — опишите текущий конвейер обменов и объём каталога. Мы разберём архитектуру, обозначим точки подготовки данных и предложим границы первого пилота с явными критериями приёмки.
Перейти к услугам PORTcore и обсудить задачу →
Связанные материалы
Подходящие офферы
Если статья попала в вашу задачу, вот два оффера, с которых можно перейти к внедрению без лишнего discovery.
Семантическое ядро и карта посадочных страниц
Собираем прикладную карту спроса и структуру страниц, чтобы SEO и коммерческий контур работали как единая система.
Редизайн посадочных под конверсию
Переделываем ключевые посадочные под понятную decision-логику, чтобы трафик не уходил в чтение без действия.