Дистрибьюторы, производители и маркетплейсы сталкиваются с одной и той же ситуацией: номенклатура расширяется быстрее, чем редакторы успевают заполнять карточки. Результат — пустые поля атрибутов, копипаст из прайс-листов поставщика вместо описаний, поиск, который не находит нужное, и конверсия ниже ожидаемой. Нанять ещё контент-менеджеров — линейное решение с линейными издержками. Автоматизировать шаблонами — помогает частично, но не решает проблему нормализации разнородных данных.
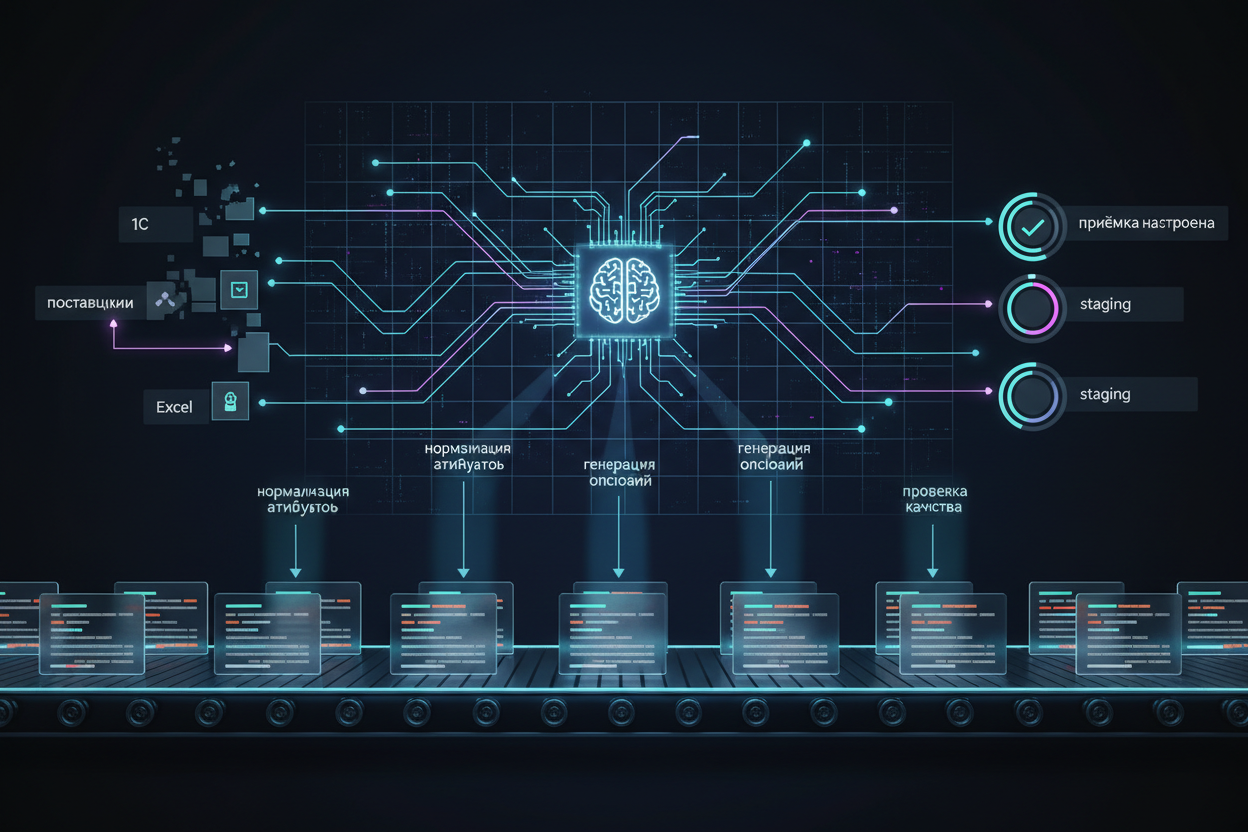
ИИ-подход здесь не про «умный ChatGPT в интерфейсе», а про конвейер: принять данные из 1С или поставщика, нормализовать атрибуты, сгенерировать описание по шаблону бренда, проверить качество и опубликовать через staging. Именно этот конвейер — предмет заказной разработки, а не покупки готового SaaS.
Что автоматизировать с ИИ: четыре сценария и их реальные ограничения
Прежде чем формулировать ТЗ, полезно выбрать сценарий — они различаются сложностью данных, стоимостью пилота и критериями приёмки.
Сценарий 1. Генерация описаний карточек товаров
Модель получает набор атрибутов (наименование, характеристики, категория) и генерирует текст описания по заданному промпту и стилистическому шаблону. Ограничение: качество выхода прямо зависит от полноты атрибутов на входе. Если в карточке три поля из двадцати — описание будет бедным. Перед запуском ИИ нужно решить задачу обогащения атрибутов, иначе автогенерация масштабирует пустоту.
Сценарий 2. Нормализация и классификация атрибутов
Из разных источников (1С, поставщики, импорт Excel) приходят одни и те же характеристики в разных форматах: «220В», «220 вольт», «AC 220». Классификатор на базе ML или LLM приводит значения к единому справочнику. Это техническая задача с измеримым результатом — процент нормализованных значений к общему числу. Критерий приёмки здесь формализуется легко.
Сценарий 3. Семантический поиск по каталогу
Стандартный полнотекстовый поиск не находит «кабель для насоса», если в карточке написано «провод ПВС 2×1,5». Векторный поиск на эмбеддингах решает эту задачу, но требует индексации всего каталога и интеграции с фронтендом. Ограничение: при частом обновлении каталога нужна инкрементальная переиндексация — это отдельная инженерная задача, которую закладывают в архитектуру с самого начала.
Сценарий 4. Контроль качества данных и флаги проблем
Автоматическая проверка: дубли, пустые обязательные поля, несоответствие категории и атрибутов, подозрительно короткие описания. ИИ-классификатор расставляет флаги, редактор видит очередь проблемных карточек вместо того, чтобы искать их вручную. Это самый быстрый сценарий для пилота — результат виден через несколько недель после запуска.
Данные и интеграции: что нужно подготовить до начала разработки
Типичная ошибка при заказе ИИ-решения для каталога — начать с модели, а не с данных. На практике 60–70% времени пилота уходит именно на подготовку данных, а не на обучение или настройку модели.
| Что нужно | Минимум для пилота | Типичные проблемы |
|---|---|---|
| Выгрузка каталога | 500–2000 карточек с атрибутами | Разные форматы из разных источников |
| Справочник атрибутов | Список обязательных полей по категориям | Отсутствует или устарел |
| Стилистический шаблон | 3–5 эталонных описаний по категории | Нет утверждённого стиля бренда |
| Доступ к API или БД | Read-доступ к staging-окружению | Только production без staging |
| Критерии качества | Чеклист приёмки с метриками | «Хорошо» без измеримых порогов |
Если каталог живёт в 1С-Битрикс и обменивается с 1С, интеграционный слой уже существует — вопрос в том, на каком этапе конвейера включается ИИ. Логично встраивать ИИ-обработку между приёмом RAW-данных и публикацией: данные нормализованы, но ещё не опубликованы, и есть возможность проверить результат до выхода в production. Такой staging-подход снижает риск публикации некачественного контента.
Подробнее о том, как устроен конвейер данных от импорта до публикации, можно прочитать в материале про аудит и ускорение каталогов с фильтрами — там разобраны типичные узкие места на уровне данных и рендера.
Пилот: что входит и чего ожидать
Разумный пилот для каталожного ИИ ограничен одной категорией или одним сценарием. Это позволяет проверить гипотезу на реальных данных компании, не вкладывая бюджет в полную интеграцию.
Чеклист пилота
- Выбрана одна категория с не менее чем 200 карточками и заполненными атрибутами
- Определён конкретный сценарий: генерация описаний, нормализация атрибутов или семантический поиск
- Подготовлено staging-окружение: ИИ пишет в отдельную таблицу или черновики, не в production
- Назначен ответственный со стороны заказчика, который проверяет выборку результатов
- Зафиксированы метрики до пилота: процент заполненных полей, среднее число символов в описании, количество жалоб на поиск
- Определён порог приёмки: например, 80% сгенерированных описаний проходят ревью без правок
- Прописан сценарий отката: если качество ниже порога, старые данные остаются в production
Пилот — это не демо вендора, а измеримая проверка гипотезы на данных компании. Если подрядчик предлагает сразу внедрить на весь каталог без пилота — это риск-сигнал.
Критерии приёмки и экономика решения
Приёмка ИИ-решения для каталога должна быть формализована до начала разработки, а не обсуждаться постфактум. Ниже — рабочая схема критериев.
Критерии качества контента
- Точность атрибутов: нормализованные значения совпадают с эталонным справочником в X% случаев (порог согласуется на старте)
- Уникальность описаний: сгенерированные тексты не дублируют друг друга более чем на Y% (проверяется автоматически)
- Соответствие шаблону: описание содержит обязательные блоки (применение, характеристики, совместимость) — проверяется структурным парсером
- Ручная выборка: редактор проверяет 10% сгенерированных карточек; доля одобренных без правок ≥ согласованному порогу
Критерии интеграции
- Данные записываются в staging, а не напрямую в production
- Есть лог операций с возможностью отката по карточке
- Время обработки одной карточки не превышает согласованного порога (важно для больших каталогов)
- Ошибки модели не блокируют публикацию вручную подготовленных карточек
Экономическая логика
Условный расчёт (не обещание): если редактор тратит в среднем N минут на заполнение одной карточки, а ИИ-конвейер сокращает это время до M минут (проверка и правка вместо создания с нуля), то экономия на партии из K карточек составляет (N − M) × K минут редакторского времени. Реальные значения N, M и K — предмет измерения на пилоте, а не допущения на этапе продажи.
Дополнительный эффект семантического поиска измеряется через долю нулевых результатов поиска до и после внедрения — этот показатель обычно доступен в аналитике сайта.
Антипаттерны: что чаще всего идёт не так
Разбор типичных ошибок при заказе ИИ для каталога помогает сформулировать правильное ТЗ.
- «Подключим ИИ к production напрямую». Без staging-слоя первая же партия некачественных описаний уходит на сайт. Исправление занимает больше времени, чем написание вручную.
- «Модель сама разберётся с форматами». LLM хорошо генерирует текст, но плохо нормализует структурированные данные без явных правил маппинга. Нормализация атрибутов — отдельная задача, не часть генерации описаний.
- «Запустим на весь каталог сразу». Без пилота на одной категории невозможно откалибровать промпты под специфику номенклатуры. Технические термины, единицы измерения и отраслевой жаргон требуют настройки.
- «Приёмка по ощущениям». Если нет измеримых критериев, команда заказчика и подрядчика будут оценивать результат по разным шкалам. Это главная причина споров на финальной сдаче.
О том, как выстроить проверку гипотезы ИИ с измеримыми критериями до полного внедрения, подробно написано в материале MVP ИИ-продукта: проверка спроса, границы функций и пилот.
Подходящие решения PORTcore для каталожных задач
В зависимости от выбранного сценария и текущей инфраструктуры задача решается по-разному.
Если каталог работает на 1С-Битрикс, сценарии генерации описаний, нормализации атрибутов и контроля качества карточек можно реализовать в рамках услуги AI-генератор контента для 1С-Битрикс — она закрывает задачу встройки ИИ-сценариев непосредственно в контур БУС-проекта без замены платформы. Для семантического поиска и персонализации есть отдельное направление AI-поиск и умные рекомендации для 1С-Битрикс.
Если нужна модерация входящих карточек от поставщиков или классификация заявок с флагами качества, подходит услуга AI-модерация каталога и заявок в Bitrix/CRM.
Для нестандартной архитектуры или каталога вне Битрикс задача решается через интеграцию AI-микросервисов — классификация, генерация и оркестрация сценариев подключаются к существующей инфраструктуре через API.
Следующий шаг
Если вы хотите понять, какой сценарий подходит для вашего каталога и что нужно подготовить для пилота — опишите задачу на странице услуг. Мы разберём структуру данных, предложим границы первого этапа и сформулируем измеримые критерии приёмки до начала разработки.
Связанные материалы
Подходящие офферы
Если статья попала в вашу задачу, вот два оффера, с которых можно перейти к внедрению без лишнего discovery.
Аудит партнёрского трафика и compliance-контур
Разбираем, как партнёрский трафик проходит через формы, CRM и отчётность, и где появляются серые зоны для бизнеса.
AI ассистент для бизнес-процессов
Внедряем AI-помощника с правилами безопасности, источниками знаний и контролем качества ответов.